01
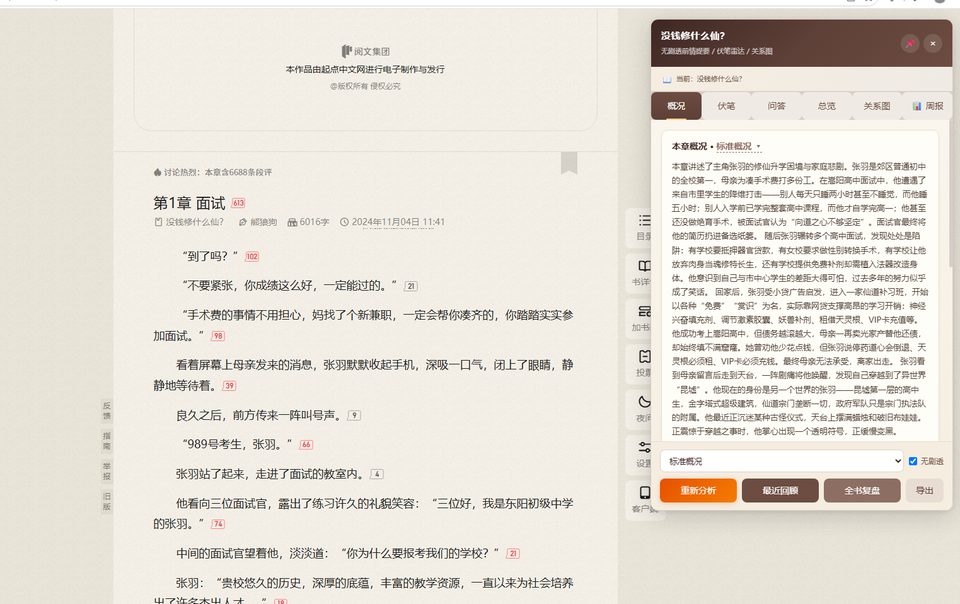
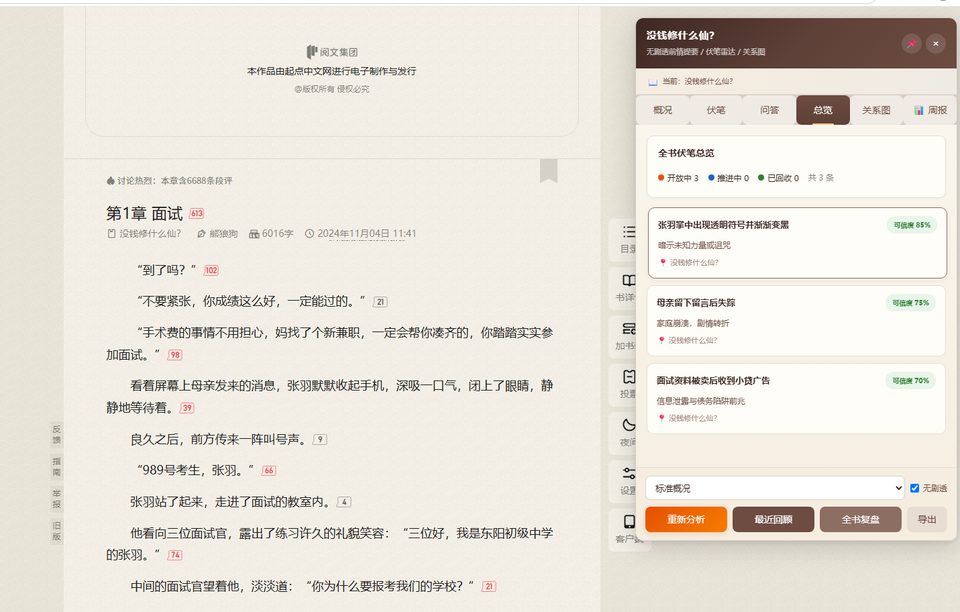
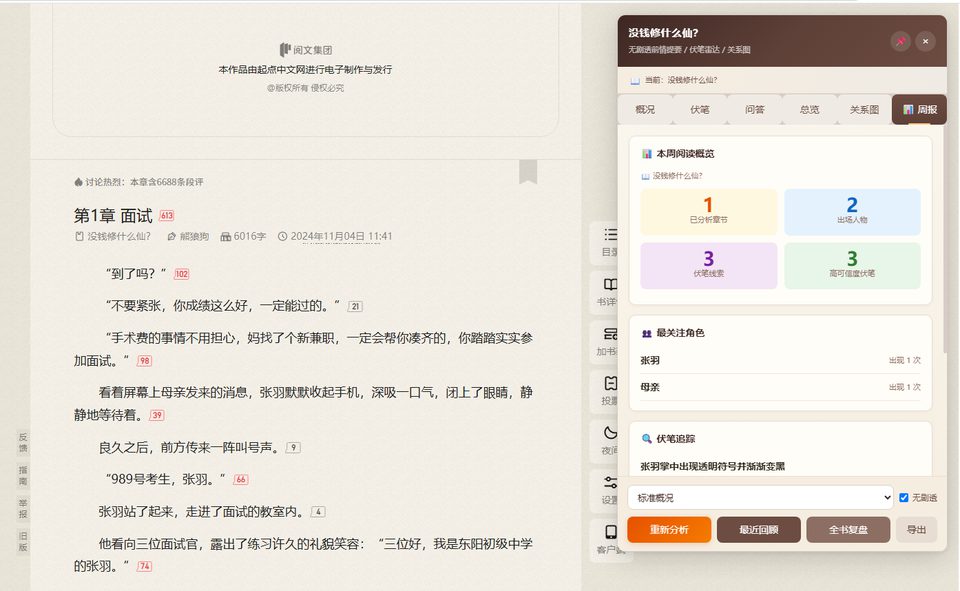
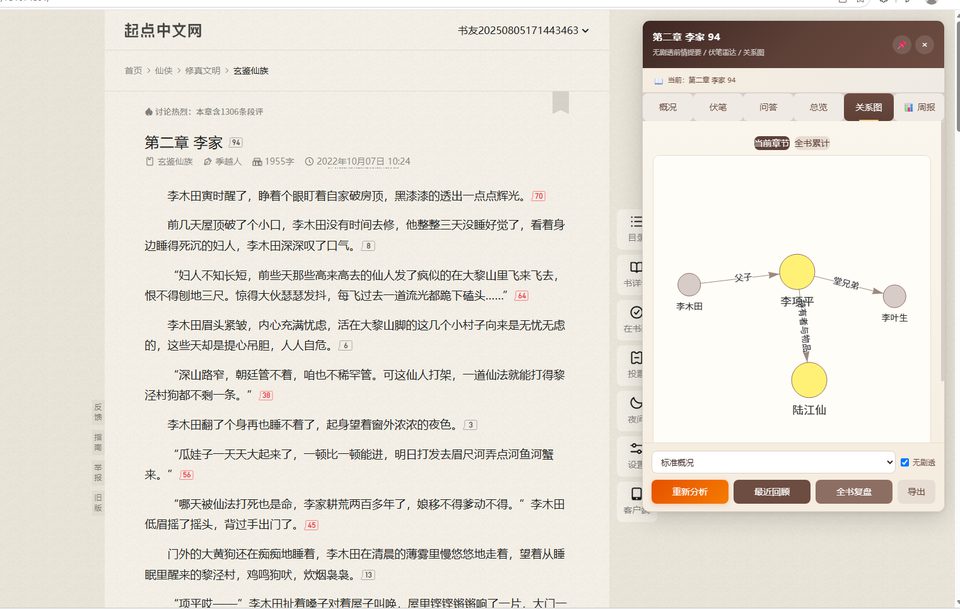
鉴来助手 小说 AI 伏笔雷达
已上线 Chrome + Edge 双商店的浏览器扩展,帮网文读者与作者在数百万字里理清人物与伏笔。
角色 · 独立完成
背景 · 用户问题
网文动辄数百万字,读者追更数月后,早期伏笔与人物关系在记忆中早已断裂;作者写到上百章也容易忘掉自己埋过的伏笔。三个具体痛点:人物关系复杂、前文遗忘、伏笔难追踪——本质都是长文本上下文人脑记不住。
用户与场景
重度网文读者(追更数月)+ 网文作者(创作连载)。场景都在「读 / 写长文本时随时需要调取记忆」,而翻找原文的成本极高。
产品目标
在数百万字里,让读者与作者「一秒回忆起」人物是谁、伏笔埋在哪——把「人脑记不住」这件事交给产品解决。
核心方案 · 结构化记忆
不是把整本书塞给模型,而是分层压缩成可检索的结构化记忆,逐层解决长文本上下文有限、成本高、信息丢失三个问题:
章节结构化摘要→阶段汇总→全局记忆
伏笔雷达在此基础上做跨章呼应识别;需要原文时按需回看,规避检索漂移。
AI 能力设计
用大模型做语义抽取与结构化(而非规则):人物、关系、伏笔、事件各落结构化字段;结构化输出图 / 表让结果可读、可核对;渐进式加载(摘要先出、详情后出、两调用并行)压低等待与成本。
★ AI 决策点
- 为什么用 LLM 而不是规则:长文本语义难以用规则覆盖;但 LLM 的事实保证弱,所以用结构化输出 + 可回原文核对来兜底。
- 为什么不能整书塞给模型:上下文窗口有限 + 成本高 + 早章信息会丢,分层摘要是用成本换完整性。
- 上下文 · 成本 · 完整性的权衡:分层摘要 + 按需回看原文,而非一次性全量 RAG。
- 哪些功能值得 AI:记忆与伏笔识别值得;「AI 生成引流文案」这类可替代的功能砍掉(YAGNI),聚焦核心价值。
- 可信度兜底:AI 生成内容存在可信度风险 → 产品加免责声明,关键结论可回原文核对。
验证 · 上线
真实上线 jianla.xyz(ICP 备案 + 公安备案);Chrome / Edge 双商店上架(权限收窄过审);多渠道分发(Chrome / Edge / 免梯 zip / Greasy Fork / 官网直链);真实用户反馈驱动的 20+ 次迭代。
迭代与复盘
番茄反爬 → 加防御性重试与兜底;AI 内容可信度风险 → 加免责声明;网络不稳定 → 状态可恢复。学会的是「上线 → 反馈 → 调整」的闭环,而不是一次做完。
浏览器扩展结构化记忆渐进式摘要权限控制SSE多端分发
02
AI Interview Agent Multi-Agent 面试训练平台
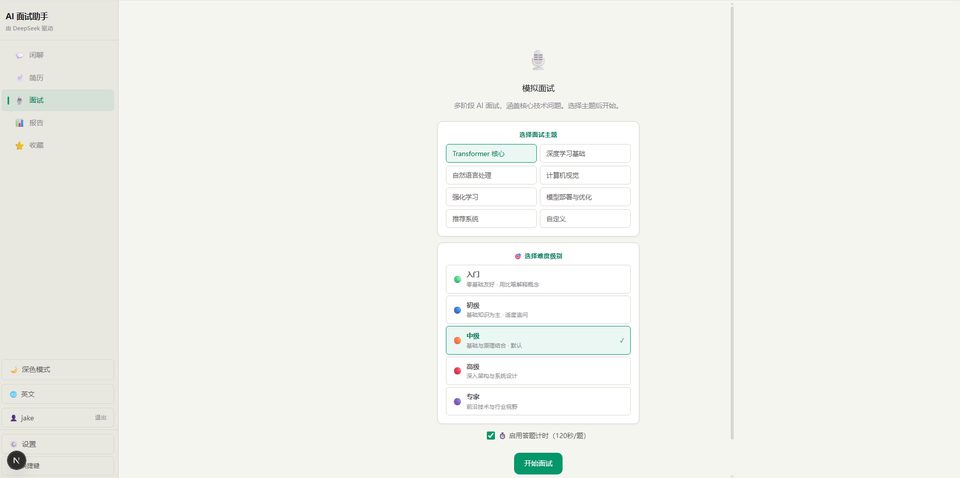
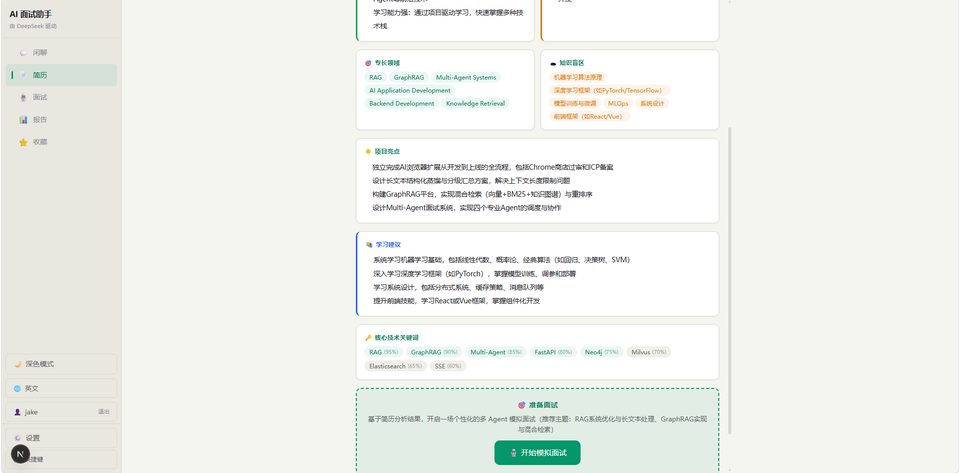
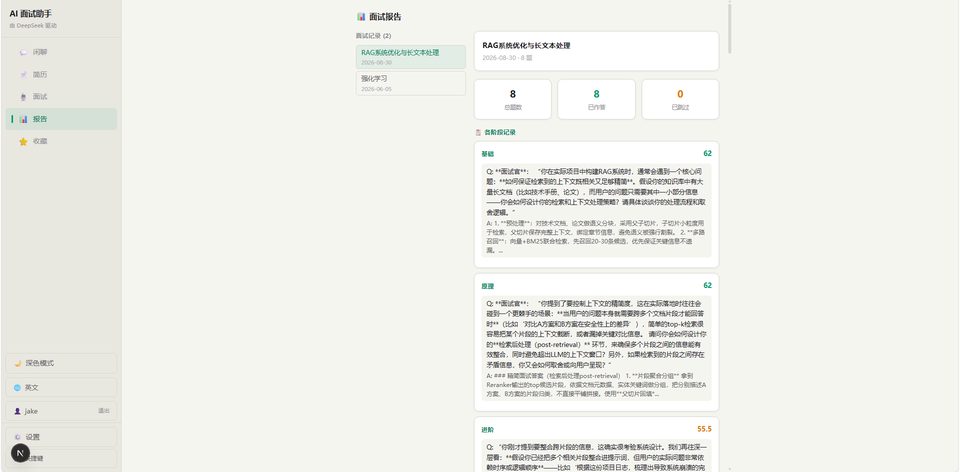
多智能体协同的面试训练系统:简历解析、模拟面试、自动评分、报告生成全流程自动化。
角色 · 独立完成
背景 · 用户问题
求职者缺练习机会,练完更缺专业反馈——没人告诉他哪句答得不好、下一步该追问什么。
用户与场景
求职者(尤其 AI / 技术岗),在正式面试前需要低成本的模拟与复盘。
产品目标
把面试拆成可自动化的流程,让用户走完一遍完整闭环:
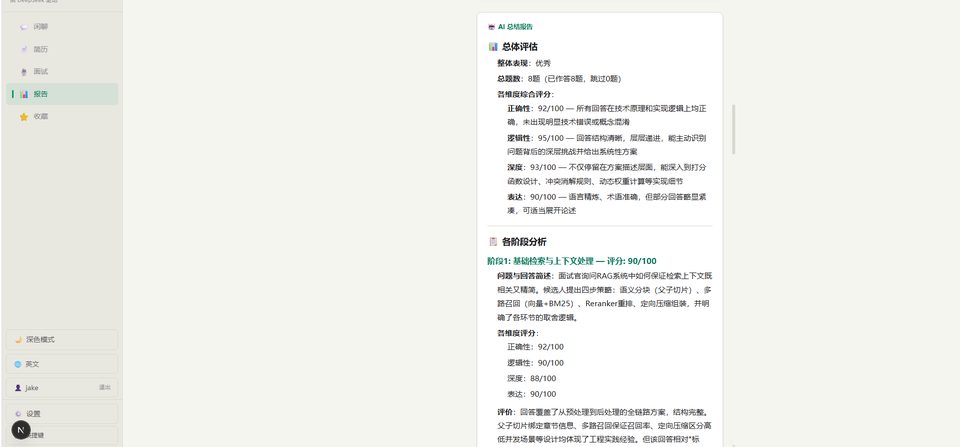
简历上传→模拟面试→动态追问→AI 评价→面试报告
核心方案
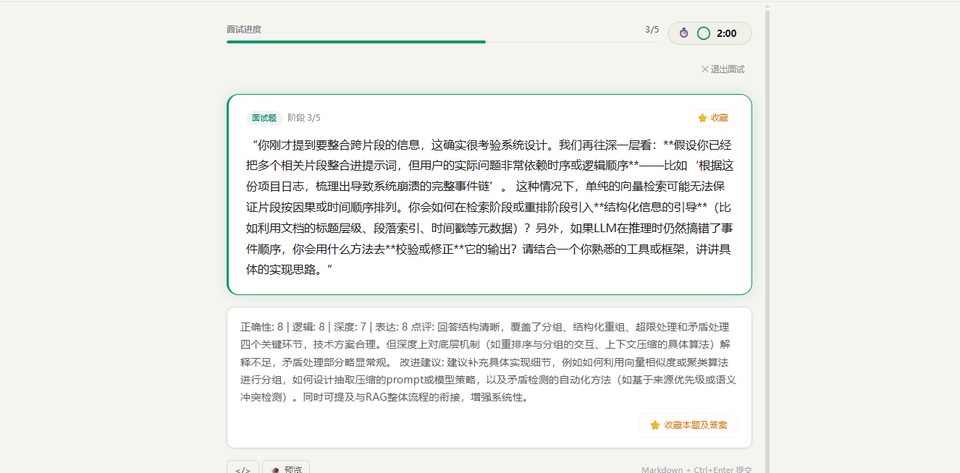
4 个 Agent 分工:Resume 解析简历、Interview 按 5 阶段提问并自动追问、Eval 实时评分、Report 生成报告。
AI 能力设计 · 为什么需要 Agent
面试是天然多步骤任务,单 Agent 一次做完会顾此失彼。拆成 4 个 Agent 各司其职:State 存当前进度与候选人画像,Memory(SharedMemory + MessageBus)让各 Agent 共享上下文不割裂;追问有次数上限、评分有结构化规则,避免 Agent 无限循环或凭空打分。
★ AI 决策点
- 为什么拆 4 个 Agent 而非单 Agent:职责分离、可独立替换,可控性更强。
- State 存什么 / Memory 解决什么:State 存进度与画像,Memory 解决跨 Agent 的上下文割裂。
- 追问怎么控制:设追问次数上限 + 终止条件,避免无限循环烧成本。
- 评分怎么可信:结构化评分维度,而非一句「不错」。
- 多模型一键切换(DeepSeek / OpenAI / Anthropic / Ollama):模型无关,不绑定单一供应商。
验证
可运行(原型级),真实跑通完整面试流程,流式交互返回。
迭代与复盘
单 Agent → 多 Agent 的取舍:可控性与可维护性提升,但复杂度与成本上升——多 Agent 不是越多越好,够用为止。
Multi-AgentState & MemorySSE多模型切换FastAPISQLite
03
GraphMind GraphRAG 知识检索与推理平台
可解释、可评估、可运营的 GraphRAG 知识平台。
角色 · 独立完成
背景 · 用户问题
市面 RAG 产品多是「套壳聊天」——回答不可信、不可评估、不可运营。
用户与场景
需要「可信知识检索」的开发者 / 企业(工程化展示项目,用来证明我理解检索与评估)。
产品目标
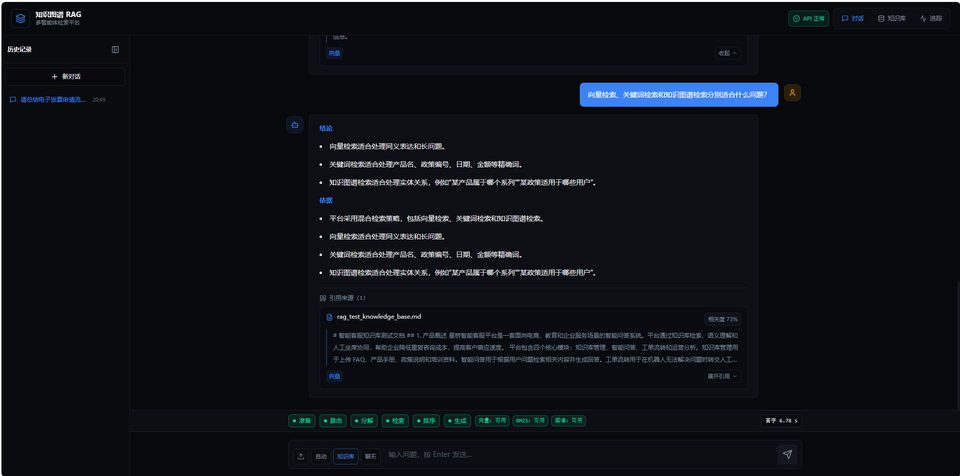
让 RAG 不是黑盒:答案能追溯来源,质量有量化红线,入库可运营。
核心方案 · 三路混合检索
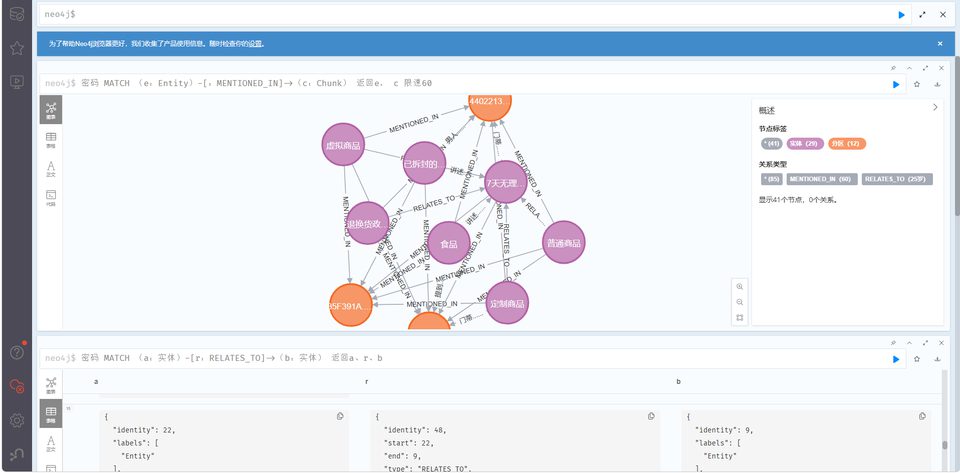
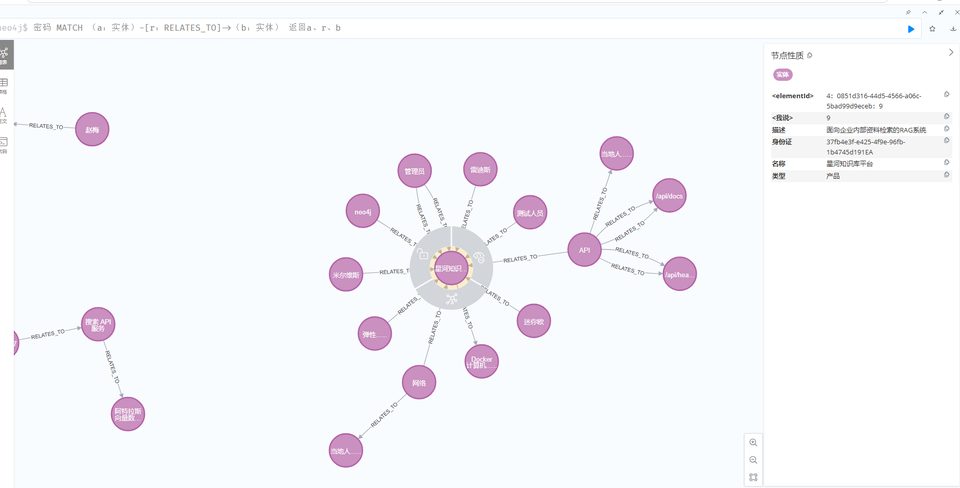
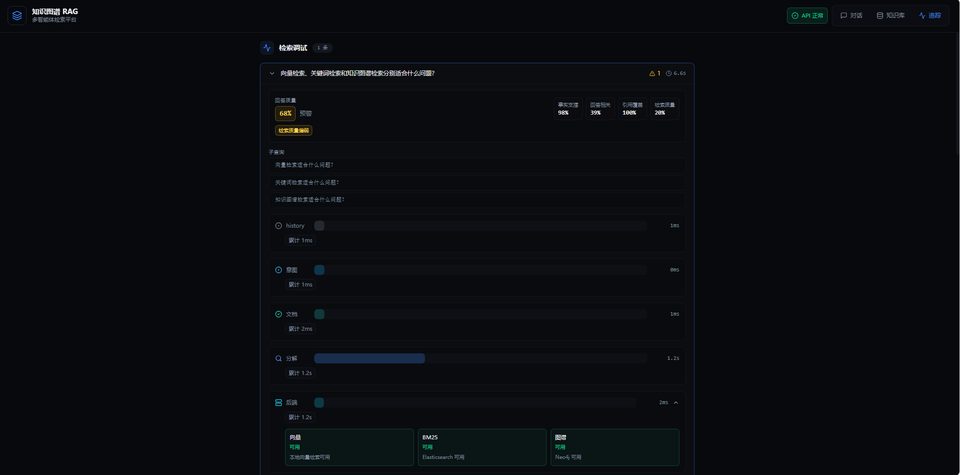
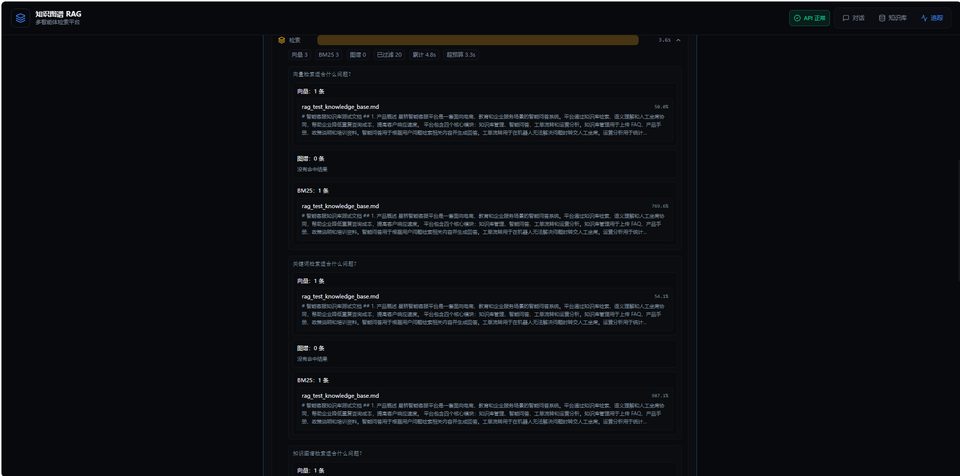
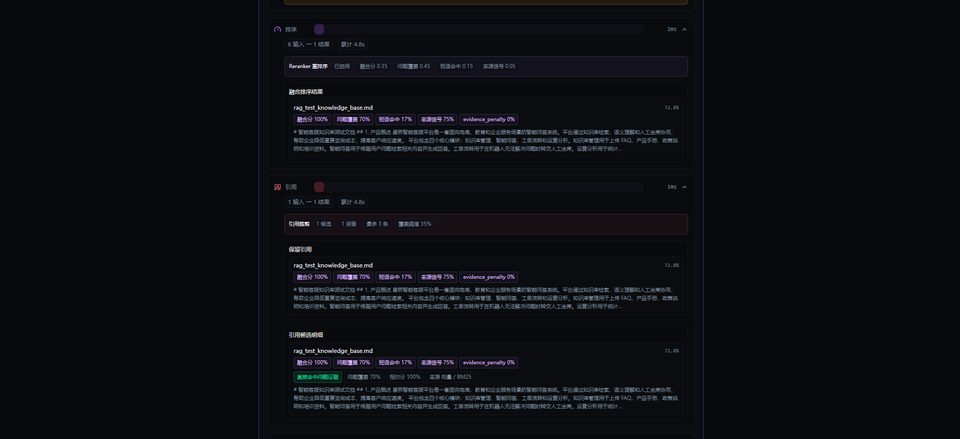
每一步都对应一个检索问题:向量检索懂语义但抓不准精确关键词 → 加 BM25 管精确关键词 → 挂知识图谱管关联推理 → RRF 融合 + Reranker 重排。
效果评估 · 怎么证明变好了
Recall 召回能不能找到相关信息
MRR相关信息是不是排在前面
Citation Precision引用是否真的支持答案
p95 latency大多数用户要等多久
用 Golden Eval 质量门禁守住这些量化红线,而不是靠「感觉变好了」。
★ AI 决策点
- 为什么混合检索:单一向量检索有短板,多路互补 + 融合重排。
- 可解释(引用 + Trace):信任是 RAG 产品的生命线。
- 质量门禁(Golden Eval):质量要有量化红线。
- 生产化入库(状态机 / 重试 / DLQ):「能跑」和「能上线」是两回事。
验证
可运行(工程化展示),内置 Demo Pack + 验收命令。
迭代与复盘
从「做能聊天的 RAG」到「做可信可评估的 RAG」——把工程能力翻译成产品价值。
GraphRAG混合检索RRF + Reranker引用溯源Golden EvalNeo4jMilvus